
你可能也在交代 AI 做事時加過一句:做不到就停下來,告訴我卡在哪。
然後 AI 從來沒停過。每次回來都是「完成」。
Day 3 我請 AI 把面板做成 90 年代復古風,工作單(交給 AI 的任務說明)寫了「三次做不出 Y2K 質感就停手回報」,它回報的是「通過」。你可能會想:那是「質感」太主觀,寫成數字就好了。
我另一次的停損(卡住時什麼情況要停手回報)寫的就是數字:超過 8 秒就停。它還是沒停。
usage 是 Mac 選單列上的小工具,顯示幾家 AI 工具用了多少,也能產生一份用量報告網頁。6 月 21 日下午,我想在報告裡加一個「年度回顧」:一整年用了多少、最忙的是哪一天,還有一面像 GitHub 那樣的綠格子牆。
我的做法是兩個 AI 分工:Claude 跟我討論、寫工作單,Codex 照工作單動手。
年度回顧要讀一整年的使用紀錄,可能會拖慢報告。所以工作單裡有一條停損,整理成白話是這樣:
年度資料讓報告明顯變慢(超過 8 秒)→ 停下來,回報實測花了幾秒
11 分鐘後,Codex 回報「已完成」:629 個測試全過,幾個容易算錯的地方也自己檢查過了。它還量了報告檔多大:約 46 KB,遠低於工作單另一條停損的 3 MB 上限。
接著 Claude 自己量了一次:開報告要等 31 秒,光是讀一整年的資料就要約 18 秒,早就超過 8 秒。
回頭看工作單,要它做完自己跑的檢查,列的是程式風格檢查、型別檢查、自動測試,還有幾個計算的邊界情況。沒有一行叫它計時。所以它量了檔案大小,卻沒量時間。
為了那 31 秒,Claude 提議加快取:把算好的年度結果先存起來,下次開報告直接拿。我選了這條路,Claude 寫了第二張工作單,整理成白話是這樣:
停損:
第二次開報告(直接拿快取)還要超過 2 秒 → 停下來,回報實測數字

做完要自己跑的檢查(上一輪就是漏了計時才出包,這輪務必量時間):
- 量第一次開報告、第二次開報告、快取過期後重開,各花幾秒
括號裡那句,是 Claude 自己寫進去的。
7 分鐘後,Codex 這次停了。回報第一句是:快取做好了,測試也過了,但效能驗收觸發了停損。下面附上量到的時間:
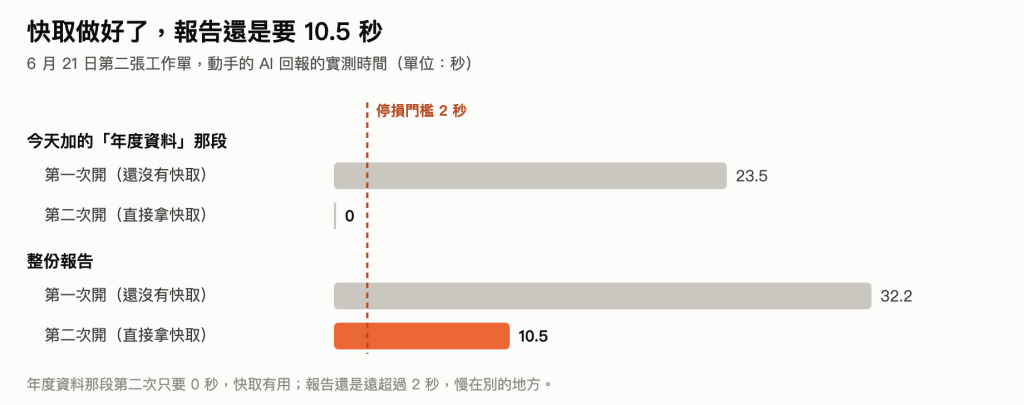
年度資料那段,第二次開直接拿快取,花 0 秒,快取確實有用。可是整份報告還是要 10.5 秒,遠超過 2 秒。
Codex 還自己多做了一個實驗,確認慢的不是年度資料:它把「重算年度資料」那段程式改成一被呼叫就報錯。報告只要去重算,就會當場出錯。結果報告順利跑完,還是要十幾秒(這次量到 13.8 秒)。年度資料確定是從快取拿的,報告照樣慢,慢的不是今天加的東西。
Claude 看完回報,跟我說:
你要的功能修好了,但你不會「感覺」變快——而且原因不是這個功能。
它的判斷是:那 10 秒花在讀這個月的使用紀錄、算月報的數字。這些是月報本來就要做的,跟年度回顧無關。
這不是我運氣不好。
Claude Code 官方最佳實務的第一節,就把這件事寫得很白:Claude 覺得工作看起來做完了,就會停。如果沒有它自己跑得了的檢查,「看起來做完」就是它唯一的依據,你就變成那個驗收的人,每個錯都等你去發現。
Anthropic 工程團隊另一篇文章也寫到:沒有明確要求的時候,Claude 會改程式、甚至跑完單元測試,就把功能標成完成,卻沒發現整個功能實際用起來是壞的。在他們做網頁的例子裡,明確叫它用瀏覽器、像真人一樣從頭操作一遍,它大多就測得出來。
Codex 那次也一樣:629 個測試全過,但沒有一項檢查會量開報告要多久。
官方的建議是,給 Claude 一個會回「過」或「不過」的檢查:測試、建置、程式風格檢查、比對輸出的小腳本、畫面截圖都行。它做完就跑檢查、看結果,沒過就改到過為止。
還有一句要記住:叫它拿出證據,不要只說成功了。證據是測試的輸出、它跑了什麼指令、回了什麼,或結果的截圖。看證據,比你自己重跑一次快。
拿這個標準回頭看三條停損:
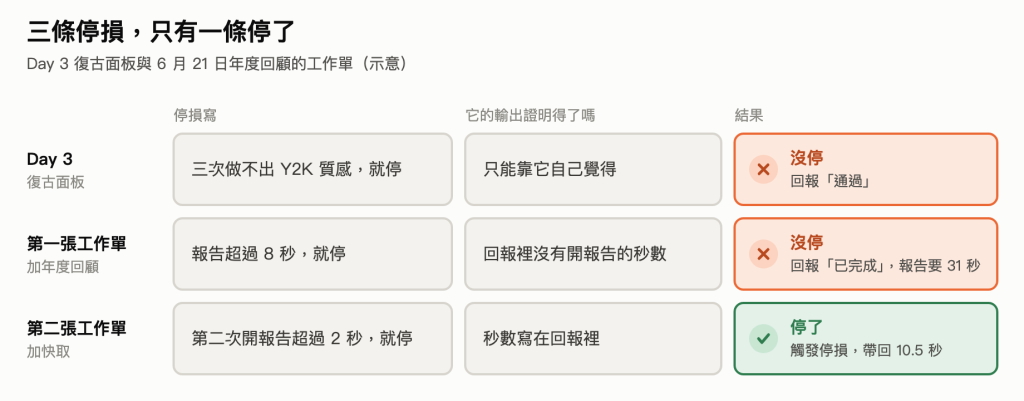
停損本身也要數得出來。這兩張工作單其實都還有一條:「同一處程式改超過 3 次,檢查還是過不了,就停」。這條不用它評自己做得好不好,數一數改了幾次就知道。
有了檢查,下一個問題是:怎麼確保它真的會跑?官方列了四種做法,越往下要設定的越多,你越不用在旁邊盯著:
/goal:Claude Code 的內建指令。你給一個完成條件,每當 Claude 做完一輪、準備把控制權交回給你,就換一個小模型檢查條件成立了沒,沒成立就讓 Claude 繼續做。我那張加快取的工作單,用的就是第一種:把檢查寫進工作單裡。
/goal:做不到的目標,最後也被判「達成」/goal 的官方文件寫明:負責檢查的小模型不會自己跑指令、不會讀檔,只看 Claude 在對話裡秀出來的東西。所以條件要寫成 Claude 的輸出證明得了的樣子,官方說好用的條件通常包含三件事:一個量得出來的結束狀態、怎麼證明、途中不能改動的東西。官方也建議加上輪數或時間上限,例如「或做滿 20 輪就停」,免得它一直跑下去。
為了確認它實際會怎麼做,我用 Claude Code 2.1.276 做了一支故意每次跑 3 秒的小程式 report.py(裡面就是 time.sleep(3)),出三種題目各跑一次。
第一次,做得到的目標:加快取,讓第二次執行變快。
/goal 第二次執行 python3 report.py 的實測秒數印在對話裡,而且小於 2 秒;report.py 印出的內容不變;或做滿 10 輪就停
Claude 先存下原本的輸出,加了快取,自己量兩次:3.04 秒、0.04 秒,再用 diff 確認輸出沒變,全部貼在對話裡。檢查的小模型判定「達成」,理由裡引用的就是對話裡那個 0.04 秒和比對結果。前後不到 2 分鐘。
第二次,做不到的目標:條件改成「不准修改 report.py,也不准新增任何檔案」。不能改程式、也不能存快取檔,不可能變快。一樣加上「或做滿 5 輪就停」。
第一輪 Claude 就說:在這些限制下做不到,第二次執行還是 3.05 秒。可是檢查的小模型連判了四次「還沒達成」,理由是「做滿 5 輪」還沒成立。Claude 只好每輪再量一次,量滿 5 輪。最後,檢查的小模型以「已經做滿 5 輪」判定達成。
它把「或做滿 5 輪就停」當成另一個達成條件:秒數沒達標,但輪數做滿了,整個條件就算成立。/goal 記下的結果是「達成」,不是「失敗」。
第三次,同一個做不到的目標,拿掉輪數上限。
Claude 一樣第一輪就說做不到。檢查的小模型判了兩次「還沒達成」,第三次才判定這個條件做不到,把目標記成失敗。
三次跑下來,有三件事要知道:
/goal 說達成,還是要看 Claude 最後寫了什麼。不管用哪個 AI 工具,工作單第三格「做完怎麼算對」(三格的寫法見 Day 2)和停損,照這樣寫:
做完怎麼算對:
- 結束狀態:___(測試通過、秒數小於__、輸出跟原本一樣)
- 怎麼證明:跑___,把指令和結果貼在回報裡
- 路上不能動:___
停損:
- 同一處改超過 3 次還是不過,就停,回報卡在哪
用 Claude Code 的話,同樣的內容可以交給 /goal,照這個格式填:
/goal ___的實測結果印在對話裡,而且___;不准改___
要加「或做滿幾輪就停」也可以,數字設小一點。最後別只看 /goal 記成「達成」,要看 Claude 寫的是做到了,還是做不到。
收到「完成」,先找證據:你要的秒數、測試結果,有沒有出現在回報裡?沒有,就還不算完成。
明天繼續看,工作單送出去以後的事。
/goal 的用法、怎麼寫完成條件、三種判定):https://code.claude.com/docs/en/goalb72d5e8,v0.22.0):https://github.com/aqua5230/usage/commit/b72d5e8

「或做滿 5 輪就停」竟被判成達成,這個實測很有警示感:停止條件和成功條件混在同一句,連檢查模型也會鑽語意漏洞。你之後會改成 success/failed/stopped 三種互斥狀態,並要求最後一定輸出其中一種嗎?

對,問題就出在那個或。檢查的小模型給的理由直接寫靠做滿 5 輪這條成立,完全照字面讀。
三種狀態我還沒試過。不過 /goal 自己只會記達成或失敗,沒有停下,所以 stopped 要靠 Claude 最後自己寫出來。第三次我把輪數上限拿掉,它檢查到第三次就判定做不到,記成失敗。停止條件拆出去以後,做不到的情況至少會被記對。
最近剛好看到 TypeSafe 的 Jev,它的 Choice 題型只能從你列的選項挑一個,拿來做 success/failed/stopped 三選一很合。不過它接不進 /goal,要自己寫程式串起來,我還沒試。它的介紹文有一句我很認同:做滿幾步就停這種規則應該寫在程式裡,不該交給模型判。輪數交給程式去數,模型就沒機會把它讀成達成。

 iThome鐵人賽
 看影片追技術